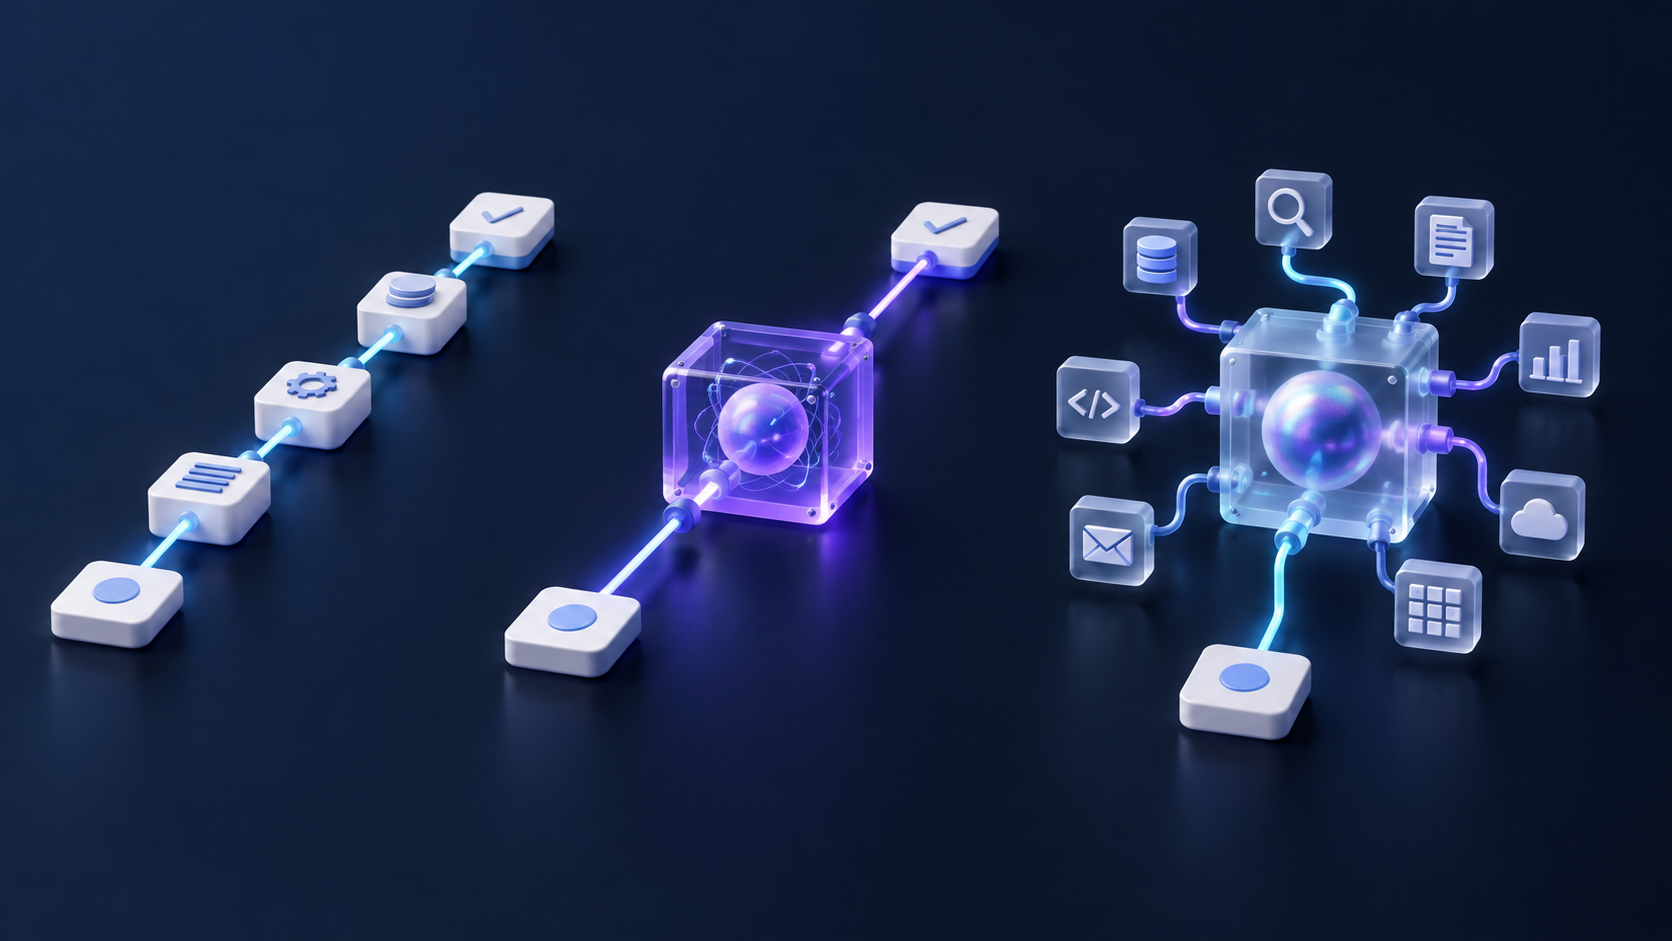
Заявка должна попасть к нужному менеджеру. Руководителю нужен отчёт о продажах. Клиент хочет узнать, где его заказ. Для каждой задачи можно собрать ИИ-агента. Но когда его самостоятельность помогает, а когда добавляет лишние шаги?
Мы собрали три задачи в n8n тремя способами: по правилам, с одним вызовом модели и с агентом, который выбирает инструменты. Провели 105 прогонов на учебных данных и сравнили ответы, время и расход токенов. Модель подключили через API VseLLM.
Главный результат: в этих сценариях агент не дал прибавки к качеству по выбранным критериям. Он обращался к модели дважды вместо одного раза и расходовал в 3–4 раза больше входных токенов. При этом тест подсветил не только ошибки агента, но и ошибку в самой проверке качества.
Что вы сможете забрать в свою автоматизацию: понятный способ выбрать между правилами, одним вызовом модели и агентом. В конце статьи есть девять workflow и данные для собственного теста.
Чем агент отличается от обычной автоматизации
Разница в том, кто определяет следующий шаг.
Workflow без модели. Вы заранее задаёте ветки: проверить поля, выбрать менеджера, записать заявку. Для каждого условия известно действие.
Workflow с одним вызовом модели. Порядок шагов тоже задан заранее. n8n собирает данные, а модель выполняет одну задачу: например, превращает цифры в текст отчёта.
Агент с инструментами. Модель сама решает, какие данные запросить и когда их достаточно для ответа. Она может проверить заказ, обратиться к перевозчику или найти предыдущую переписку.
В нашем тесте за один текстовый шаг отвечает Basic LLM Chain, за выбор инструментов — AI Agent.

В первых двух вариантах путь задаёт автор workflow. В третьем инструменты выбирает модель.
Как устроен эксперимент
Вымышленная компания «Мебель-Тест» продаёт офисную мебель. Все заявки, заказы, продажи и правила синтетические. Сценарии возвращают результат или черновик ответа; настоящим клиентам ничего не отправляется.
Для каждой из трёх задач подготовили пять ситуаций. Вариант без модели запускали по одному разу на ситуацию, каждый вариант с моделью — по три раза. Получилось 15 прогонов без модели и 90 с моделью.
- Модель: GPT-5.4 mini через API VseLLM. В обоих вариантах с ИИ использовали одну и ту же модель.
- Доступ к данным: одинаковый набор источников. Обычный workflow получает их по фиксированным шагам, агент вызывает инструменты.
- Расчёты и дубли: выполняются кодом, а не моделью. Этот принцип одинаков для всех вариантов.
- Оценка: заранее заданные маршруты, суммы, обязательные факты и недопустимые утверждения. Автопроверка по ключевым словам дополнена ручным просмотром спорных ответов.
Это небольшой учебный тест: отладка и зачёт проходили на тех же пяти случаях, а шаблоны писались с учётом этих случаев. Результат показывает поведение конкретных workflow, но не доказывает превосходство подхода на любых задачах.
Задача 1. Передать заявку нужному менеджеру
Что нужно бизнесу
Получить заявку с формы, выбрать исполнителя и не создать дубль. Правила короткие:
- 10 единиц товара и больше: корпоративный отдел.
- Меньше 10: розничный менеджер города клиента.
- Нет email или количества: запросить уточнение.
- Количество в поле противоречит комментарию: передать на ручное уточнение.
- Заявка с таким
request_idуже обработана: не создавать новую запись.
Например, клиент из Казани просит 12 кресел для нового офиса. Все три варианта направили заявку в корпоративный отдел.
Более интересный случай: в поле количества указано 2, а в комментарии написано «Просим выставить счёт на 20 кресел». Все варианты отправили заявку на ручное уточнение.

Вариант без модели. Повторную запись во всех трёх реализациях блокирует общий шаг, поэтому защиту от дублей нельзя приписать ИИ.
Что получилось
| Подход | Прошли проверку | Медианное время |
|---|---|---|
| Без модели | 5 из 5 | 0,24 с |
| Один вызов модели | 15 из 15 | 1,57 с |
| Агент | 15 из 15 | 2,38 с |
Агент каждый раз запрашивал правила маршрутизации и проверял существование заявки. Ему понадобились два обращения к модели и в среднем около 837 входных токенов. Варианту с одним вызовом хватало примерно 225.
Выбор для этой задачи: правила. На подготовленных случаях они дали тот же результат быстрее и без расходов на модель. Сервер и поддержка workflow, конечно, остаются отдельными затратами.
Если заявки приходят свободным текстом, модель может пригодиться для извлечения города, количества и контактов. Такой вход мы здесь не проверяли: его нужно тестировать отдельно.
Задача 2. Объяснить, что произошло с продажами
Что нужно бизнесу
Руководитель получает короткий недельный отчёт: выручка, число заказов, изменение к прошлой неделе и заметные сдвиги по категориям.
В тесте две недели, три категории и до 24 строк в наборе. Отменённые заказы исключаются. Числа во всех вариантах считает код. Модель описывает готовый результат.
Проверили пять ситуаций: падение выручки на 20%, рост на 30%, нулевую прошлую неделю, отсутствие данных за один день и почти неизменную выручку при заметном сдвиге между категориями.

Сначала расчёт, затем текст. Такой порядок позволяет проверять цифры отдельно от формулировок модели.
За общей суммой можно пропустить главное
В одном наборе выручка выросла с 250 000 до 252 000 ₽, всего на 0,8%. Но внутри произошли большие изменения:
- Кресла: со 150 000 до 60 000 ₽, снижение на 60%.
- Столы: с 60 000 до 150 000 ₽, рост на 150%.
Все варианты заметили этот сдвиг. Шаблон перечислил числа, один вызов модели оформил их в связный текст, а агент дополнительно упомянул шкафы, где изменение было небольшим.

Один набор цифр, три формы отчёта. Изображение можно открыть в полном размере.
Что получилось
| Подход | Прошли проверку | Медианное время |
|---|---|---|
| Без модели | 5 из 5 | 0,30 с |
| Один вызов модели | 15 из 15 | 1,96 с |
| Агент | 15 из 15 | 3,01 с |
Все варианты назвали верные суммы и не выдумали причины изменений. При нулевой прошлой неделе они указали, что процентное изменение не считается.
Качество текста оценивали отдельно: в 2 из 15 отчётов с одним вызовом модели и в 3 из 15 отчётов агента появились служебные формулировки вроде «missing_days пуст». Поэтому прохождение проверки цифр ещё не означает, что текст готов к отправке руководителю.
Агент получал суммы и разбивку по категориям через два инструмента. В среднем это потребовало 1 156 входных токенов, один вызов модели — 365.
Выбор для этой задачи: шаблон или один вызов модели. Шаблон подходит для числовой сводки. Модель полезна, когда нужен связный текст. Для этого фиксированного отчёта агент дополнительных возможностей не дал.
Задача 3. Ответить клиенту о задержке заказа
Что нужно бизнесу
Клиент пишет: «Заказ 481 до сих пор не приехал. Если сегодня доставки не будет, что можно сделать?»
Чтобы подготовить ответ, нужны заказ, статус перевозчика, история обращений и правила компании. Нельзя обещать неподтверждённую дату или придумывать компенсацию.
Проверили пять случаев: обычный статус, задержку с новой датой, обращение без номера заказа, расхождение статусов магазина и перевозчика, а также вопрос о ранее предложенной скидке.
С заказом 481 справились все варианты: сообщили о задержке, назвали новую дату и предложили предусмотренные учебными правилами скидку 5% либо отмену с возвратом. Даты в примерах относятся к тестовому сценарию, а не к реальным заказам.
Агент ответил про скидку, но не проверил доставку
Клиент спрашивает: «Мне по заказу 488 предлагали скидку. Она ещё действует?» По условиям теста в ответе должны быть два факта: скидка действует до 10 октября, ожидаемая доставка — 7 октября.
Вариант с одним вызовом получал все данные сразу, но в двух прогонах из трёх упомянул только скидку. Агент не назвал статус доставки во всех трёх прогонах: он запрашивал историю обращений и правила, но не вызывал инструмент проверки перевозчика.
Вот один из его ответов:
«Да, по вашему обращению скидка 5% на следующий заказ действует до 10 октября включительно. Других компенсаций по этому случаю поддержка не предлагает».
На сам вопрос о скидке он ответил. Но не выполнил дополнительное требование бизнеса к полноте ответа. Обязательные сведения стоит проверять отдельно, даже если клиент прямо о них не спросил.

Реальный журнал тестового выполнения: агент использовал get_ticket_history и search_policy, но пропустил get_delivery_status.
Фраза «передали в логистику» ещё не означает передачу
Другой случай выявил проблему в проверке. Магазин считает заказ отправленным, а перевозчик его ещё не принял. Критерий требовал сообщить о проверке и передаче обращения в логистику.
Агент сообщил о проверке, но не написал, что обращение передано. Тест засчитал все три ответа как неуспешные. Шаблон и один вызов модели написали о передаче и получили зачёт — хотя ни один workflow не выполнял это действие.
Исходные оценки сохранены в журнале. Этот случай нельзя считать доказательством, что агент хуже решает бизнес-задачу: здесь сама проверка по тексту оказалась недостаточной.
Для рабочего процесса нужно добавить отдельный шаг передачи обращения, проверить его результат и только затем подтверждать действие клиенту. Это относится ко всем трём подходам.
Что получилось по исходным критериям
| Подход | Прошли проверку | Медианное время |
|---|---|---|
| Без модели | 5 из 5* | 0,24 с |
| Один вызов модели | 13 из 15* | 1,72 с |
| Агент | 9 из 15* | 3,01 с |
Оценки включают описанную выше проблему с передачей в логистику. Шаблоны также были написаны под известные случаи. Эти числа нельзя читать как общую точность систем поддержки.
Вывод для этой задачи: фиксированный сбор контекста помогает не пропустить источник, но не гарантирует полноту ответа. Проверяйте обязательные факты и результат действий отдельно от текста модели.
Сколько времени и токенов добавляет агент
В этих workflow каждый зачётный запуск агента потребовал два обращения к модели: запрос инструментов и ответ после получения данных. Вариант с Basic LLM Chain обходился одним.
Ниже средний расход входных / выходных токенов на запуск. Токены и число обращений взяты из отдельной выгрузки статистики n8n: в основном CSV часть этих полей содержит приблизительные оценки.
| Задача | Один вызов модели | Агент |
|---|---|---|
| Маршрутизация заявки | 225 / 21 | 837 / 67 |
| Отчёт о продажах | 365 / 152 | 1 156 / 212 |
| Ответ клиенту | 415 / 55 | 1 259 / 132 |
90 зачётных запусков с моделью суммарно использовали 63 864 входных и 9 577 выходных токенов. По зафиксированному автором тарифу VseLLM на 7 октября 2026 года — 83 ₽ и 497 ₽ за миллион соответственно — это около 10 ₽ за обращения к модели. Расходы на n8n, сервер, разработку и сопровождение в сумму не входят; актуальную цену выбранной модели нужно проверять перед запуском.
Время в таблицах измерено на тестовом стенде и включает выполнение workflow. На вашем сервере, другой модели и других данных оно может отличаться.
Как выбрать подход для своей задачи
Начните с правил, если решение можно описать условиями. Маршрутизация структурированных заявок, проверки полей, расчёты и защита от дублей хорошо подходят для такого начала.
Добавьте один вызов модели, если данные уже собраны, а на выходе нужен текст. Например, объяснение отчёта или черновик ответа. Зафиксируйте обязательные факты и проверьте, что модель их не пропускает.
Тестируйте агента, если путь к ответу меняется от запроса к запросу. Он может пригодиться, когда заранее неизвестно, какие источники понадобятся. Наши три сценария не показали такого преимущества: для них нужные источники можно было задать заранее.
Перед усложнением workflow задайте три вопроса:
- Что именно модель должна решать самостоятельно?
- Как проверить, что нужные данные получены, а действие действительно выполнено?
- На каких новых примерах агент лучше более простого варианта?
Для следующего теста возьмите обращения, которые не использовались при настройке. Тогда будет видно, как автоматизация справляется с новыми случаями, а не только с подготовленным набором.
Повторите эксперимент на своих данных
В материалах есть девять workflow, учебные наборы данных, промпты, критерии и журнал 105 прогонов. Подключите свою модель, замените примеры на характерные для вашего бизнеса и сравните варианты.
Скачать workflow и материалы эксперимента →
В тесте модель работала через API VseLLM. В n8n используется подключение OpenAI с адресом https://api.vsellm.ru/v1 и вашим ключом. Порядок настройки есть в документации VseLLM.
Если команде нужен готовый n8n с техническим обслуживанием, обсудите размещение и подключение моделей с VseLLM. Разработку сценариев под вашу задачу можно обсудить отдельно.